
Najkrócej
Dobór próby badawczej to wybór z populacji tych osób, które zostaną zbadane, tak by wynik dało się przenieść na całą grupę docelową. Ważniejsze od liczebności jest to, jak je wybrano: tylko dobór losowy pozwala policzyć błąd statystyczny. Przy 95% ufności 400 osób dobranych losowo daje błąd ok. ±5 pp (punktów procentowych).
- Dlaczego: tylko próba losowa pozwala policzyć błąd statystyczny.
- Liczby: 400 osób daje błąd ok. ±5 pp.
- Jak: liczebność planuj pod najmniejszą podgrupę, którą będziesz czytać osobno.
- Uwaga: ankieta w mediach społecznościowych to samoselekcja, nie próba.
Od czego zaczyna się dobór próby?
Od ustalenia populacji, czyli wszystkich osób, o których chcesz wnioskować. W badaniu konsumentów rzadko są to „wszyscy Polacy”. Zwykle to grupa docelowa zawężona kryterium, na przykład kupujący daną kategorię w ostatnich 3 miesiącach. Dopiero potem szuka się listy, z której da się kogoś wylosować lub zaprosić.
Taka lista to operat losowania: zbiór jednostek, które można zidentyfikować i włączyć do próby. Musi być aktualny i kompletny, bo próba nie przekroczy jego granic. Baza klientów z programu lojalnościowego pomija kupujących bez karty, więc nawet idealne losowanie z niej opisze tylko posiadaczy karty. O reprezentatywności mówimy wtedy, gdy struktura próby zgadza się z populacją w cechach istotnych dla pytania badawczego. Jeśli operat ich nie obejmuje, nie ma jej z czego zbudować.
Cały proces ma siedem etapów:
- Zdefiniuj populację.
- Wybierz operat.
- Wybierz metodę doboru.
- Ustal wielkość próby.
- Zaplanuj realizację założeń.
- Zbierz dane.
- Sprawdź poprawność doboru.
Metoda i liczebność to etapy trzeci i czwarty, więc zależą od dwóch pierwszych. Czytając cudzy raport, zaczynam od pytania, kogo zbadano, a dopiero potem patrzę na wyniki.
Jakie są metody doboru próby badawczej?
Są dwie rodziny: dobór losowy (probabilistyczny) i nielosowy (nieprobabilistyczny). Dzieli je jedno kryterium: czy każda osoba z operatu ma znaną szansę wejścia do próby. Tylko wtedy błąd statystyczny da się policzyć, bo dla próby nielosowej jest co najwyżej przybliżeniem. W praktyce badań marketingowych dobór respondentów to najczęściej dobór kwotowy.
Dobór losowy: prosty, warstwowy, systematyczny, grupowy
- Prosty: każdy element operatu ma jednakową szansę trafienia do próby. W badaniu konsumentów to losowanie z bazy klientów.
- Warstwowy: populację dzieli się na rozłączne warstwy (region, częstotliwość zakupów) i losuje w każdej osobno. Pomaga, gdy interesuje cię grupa rzadka, na przykład klienci premium: w prostej próbie byłoby ich za mało albo próba musiałaby być bardzo duża.
- Systematyczny: wybiera się co k-ty element listy po losowym starcie, gdzie k = N/n. Z listy 2000 klientów co 20. osoba daje 100 ankiet.
- Grupowy (zespołowy): losuje się całe grupy, na przykład sklepy, a w nich bada wszystkich klientów w danej godzinie. W terenie jest taniej, ale błąd jest większy niż w prostej próbie tej samej wielkości.
Dobór nielosowy: kwotowy, celowy, dostępności i kula śnieżna
Dobór kwotowy to standard badań konsumenckich, w tym paneli online. Kwoty odtwarzają strukturę populacji według wybranych cech, na przykład płci, wieku i wielkości miejscowości, zgodnie z danymi o populacji. Wybór konkretnych osób w ramach kwoty należy jednak do ankietera lub panelu i nie jest losowy. Kwota daje więc strukturę, ale nie daje losowości. Panele online realizują takie próby w ankiecie internetowej CAWI.
Dobór celowy polega na tym, że badacz wybiera osoby typowe lub najważniejsze dla pytania. Stosuje się go w badaniach jakościowych, na przykład w indywidualnych wywiadach pogłębionych (IDI), gdzie opisuje się nawet dobór celowo-losowy z kryterium różnorodności. Liczebności nie wyznacza tu wzór, więc badanie na kilkunastu osobach nie jest „za małe”, tylko służy czemu innemu niż szacowanie odsetków. W pracach dyplomowych dobór celowy bywa jedynym wykonalnym i trzeba go nazwać wprost.
Dobór dostępności (wygodny) bierze tych, do których najłatwiej dotrzeć. Kula śnieżna polega na tym, że respondenci wskazują kolejnych, co sprawdza się przy grupach trudno dostępnych.
| Metoda | Jak dobiera osoby | Czy liczy się błąd | Typowe użycie w badaniu konsumentów | Główne ryzyko |
|---|---|---|---|---|
| Prosty | Losowanie z operatu, równa szansa | Tak | Ankieta wśród klientów z bazy | Za mało osób z grup rzadkich |
| Warstwowy | Losowanie w rozłącznych warstwach | Tak | Region, częstotliwość zakupów, klienci premium | Potrzebna wiedza o strukturze operatu |
| Systematyczny | Co k-ty element po losowym starcie | Tak | Lista klientów lub transakcji | Uporządkowanie listy może zniekształcać próbę |
| Grupowy | Losowanie całych grup (sklepy, osiedla) | Tak, większy niż w prostej | Badanie wyjściowe w sklepach | Osoby w grupie są do siebie podobne |
| Kwotowy | Ankieter lub panel wypełnia kwoty | Tylko przybliżenie | Panele CAWI, ankiety konsumenckie | Kwota nie gwarantuje losowości |
| Celowy | Badacz wybiera osoby typowe lub najważniejsze dla pytania | Nie | Wywiady pogłębione | Subiektywność wyboru |
| Dostępności | Pierwsi, do których łatwo dotrzeć | Nie | Szybki test pomysłu | Próba opisuje tylko najdostępniejszych |
| Kula śnieżna | Respondenci wskazują kolejnych | Nie | Grupy trudno dostępne | Zamknięty krąg znajomych |
Jak duża powinna być próba?
To zależy od dopuszczalnego błędu, nie od wielkości populacji, o ile ta jest duża. Im mniejszy błąd ma mieć wynik, tym większa próba: dla ok. ±3 pp potrzeba około 1000 osób dobranych losowo. Błąd dla proporcji liczy się ze wzoru:
e = 1,96 × √(p × (1 − p) / n)
Tu p to frakcja (udział badanej odpowiedzi), n to liczebność próby, a 1,96 odpowiada 95% ufności. Największy błąd wychodzi przy p = 0,5, dlatego do planowania przyjmuje się właśnie tę wartość. Kalkulatory doboru próby liczą ten sam wzór z czterech danych: wielkości populacji, poziomu ufności, frakcji i dopuszczalnego błędu.
Przyjmijmy hipotetycznie p = 0,5:
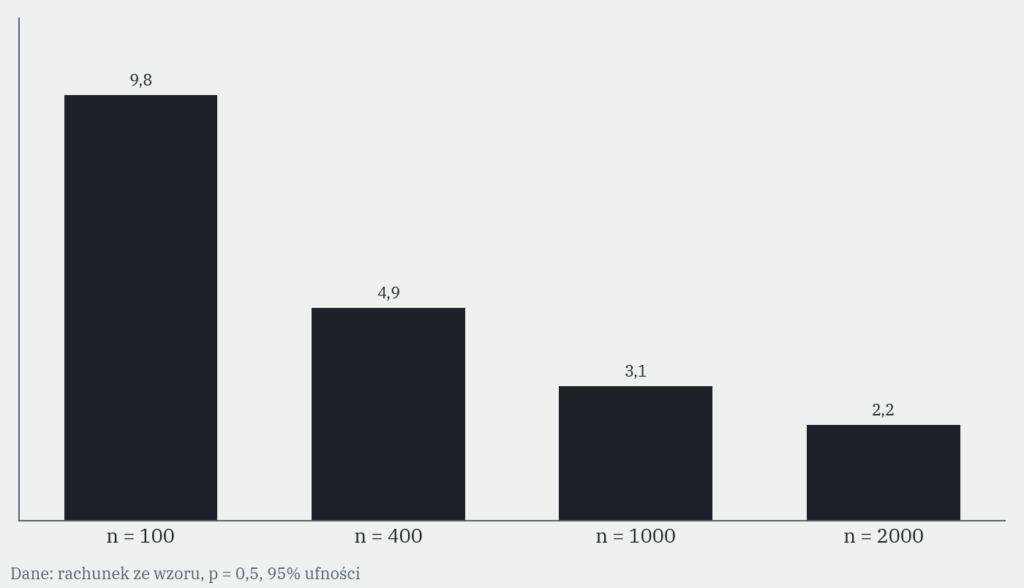
| Liczebność próby (n) | Błąd przy 95% (p = 0,5) |
|---|---|
| 100 | ±9,8 pp |
| 400 | ±4,9 pp |
| 1000 | ±3,1 pp |
| 2000 | ±2,2 pp |
Błąd maleje z pierwiastkiem z n: czterokrotnie większa próba daje błąd o połowę mniejszy. Dlatego podwojenie próby z 1000 osób zmniejsza go o niecały punkt procentowy, a wymaga dwa razy więcej ankiet.
Przy wyniku dalekim od połowy błąd jest mniejszy: dla p = 0,2 i n = 400 wynosi ±3,9 pp. Te rachunki dotyczą próby losowej, a dla panelu z kwotami raporty podają je jako przybliżenie.
Rachunek można odwrócić, żeby z góry zaplanować liczebność: n = 1,96² × 0,25 / e². Dla błędu pięciu punktów procentowych wychodzi ok. 385 osób, dla trzech punktów ok. 1070.
Gdy populacja jest mała, stosuje się poprawkę na populację skończoną: n = n₀ / (1 + (n₀ − 1)/N), gdzie N to wielkość populacji, a n₀ wynik z poprzedniego wzoru.
Przy bazie 2000 klientów zamiast 385 ankiet wystarczy ok. 323. Przy populacji liczonej w milionach poprawka nic nie zmienia.
Co, jeśli wyniki czytasz w podgrupach albo porównujesz dwa pomiary?
Liczebność planuje się pod najmniejszą podgrupę, którą będziesz czytać osobno. Jeśli próbę rozbijesz na 4 regiony po 100 osób, wynik każdego regionu ma błąd ok. ±10 pp, dwa razy większy niż dla całości.
Podobnie z porównaniem dwóch pomiarów, na przykład przed kampanią i po niej. Różnica ma większy błąd niż każdy z wyników osobno. Przy dwóch niezależnych próbach po 400 osób różnica musi przekroczyć ok. 7 pp, żeby nie mieścić się w błędzie. Wynika to z tego samego wzoru, w którym pod pierwiastkiem sumuje się obie próby:
1,96 × √(0,25/400 + 0,25/400) ≈ 6,9 pp
Wzrostu świadomości marki o 3 pp na takich próbach nie da się więc odróżnić od przypadku. Jak zaplanować taki pomiar, opisuje badanie skuteczności reklamy z pretestem i posttestem.
Na czym polega ważenie próby?
Ważenie nadaje odpowiedziom wagi, tak by struktura zrealizowanej próby (płeć, wiek, wielkość miejscowości, region) zgadzała się ze znaną strukturą populacji. Grupom niedoreprezentowanym waga rośnie, nadreprezentowanym maleje.
Przyjmijmy, że osoby 55+ stanowią 30% próby, a 40% populacji. Ich odpowiedzi dostają wtedy wagę ok. 1,33, a odpowiedzi grup nadreprezentowanych wagę poniżej jedności.
Ważenie ma granice. Nie dorobi grupy, której w próbie nie ma: w badaniu online nie zastąpi osób bez internetu. Duże wagi zwiększają też niepewność wyniku, bo kilka odpowiedzi zaczyna liczyć się za wiele.
Jakie błędy w doborze próby zdarzają się najczęściej?
Najczęściej próba nie odpowiada populacji, której dotyczy wniosek. Błędy doboru rzutują na całe badanie i trudno je wykryć bez prześledzenia metodologii.
- Ankieta udostępniona w mediach społecznościowych lub newsletterze to samoselekcja: odpowiadają obserwujący markę i najbardziej zaangażowani. Zawyża to oceny marki, zwłaszcza wynik NPS.
- Operat jest niekompletny: baza klientów zamiast wszystkich kupujących kategorię.
- Próba nielosowa jest opisana jak losowa, z błędem „±x pp” podanym z dokładnością do dziesiątych.
- Podgrupa w wynikach jest za mała, by czytać ją osobno.
- Raport nie podaje n ani sposobu doboru.
Wynik bez podanego n i opisu doboru uznaję za niesprawdzony: najpierw sprawdzam n i metodę, dopiero potem czytam wnioski.

Leave a Reply